RTX 3090 em 2026: o que ela roda de verdade (medido) e se vale R$ 10 mil
Em 2026, a pergunta sobre uma RTX 3090 não é “se ela é antiga”. É se 24 GB de VRAM ainda abrem espaço para modelos úteis, com velocidade que dá para usar no dia a dia. A resposta curta: sim, para IA local, e não para quem quer só jogar sem se importar com configuração.
A placa que está à venda na Orbe é uma Gigabyte RTX 3090 24 GB GDDR6X, em condição como nova, por R$ 10.000,00 (produto /3090). Antes de colocar preço, ela passou por medições reais: serviu como servidor de IA local 24/7 numa máquina Xeon E5-2680 v4 (inference-paraguai/docs/status.md). Isso importa porque o teste não foi “abrir o benchmark e tirar print”. Foi rodar modelos, medir tokens por segundo, checar VRAM, temperatura, disponibilidade e trabalho real.
Por que 24 GB importam em 2026
Para LLM local, VRAM é o gargalo mais visível. Se o modelo não cabe, não roda. Se cabe apertado, a experiência fica lenta ou instável. A RTX 3090 tem 24 GB de GDDR6X (hardware: Gigabyte RTX 3090 24 GB GDDR6X). Na prática, isso permitiu rodar Qwen 3.8 27B com draft model ocupando 22,1–22,9 GB de 24 GB (report/gpu.csv). Ou seja: o modelo coube, mas não sobrou folga enorme. Para quem quer rodar modelos de 27B com quantização e especulação, 24 GB ainda é um tamanho útil. Para quem quer rodar modelos maiores sem quantização agressiva, pode não ser suficiente.
O que roda e a que velocidade
A tabela abaixo resume as medições que usamos. Todos os números vêm de arquivos ou logs citados na seção final.
| Modelo | Configuração | Velocidade medida | Fonte |
|---|---|---|---|
| Qwen 3.8 27B | EXL3 + decodificação especulativa DFlash2, exllamav3 | ~34,5 tok/s em 1 stream sem especulação | SPEC.md |
| Qwen 3.8 27B | EXL3 + DFlash2, exllamav3 | ~90 tok/s com especulação, primeiro byte < 1 s | docs/7-clientes.md |
| Qwen 3.8 27B | Gateway LiteLLM, 14 respostas longas | média 70,9 tok/s; máximo 101,8 tok/s | LiteLLM SpendLogs, 28–29/09/2026 |
| Qwen 27B | GGUF Q5, llama.cpp | 23 tok/s | bestmodel.run, medição do dono 28/09/2026 |
| Gemma 4 12B | W4A16, vLLM | 66,5 tok/s com 1 pedido; TTFT 253 ms | report/FINAL.md |
| Gemma 4 12B | W4A16, vLLM | 485,7 tok/s somados com 8 pedidos simultâneos | report/FINAL.md |
O mesmo modelo de 27B pode rodar a 23 tok/s ou a ~90 tok/s dependendo do formato, engine e estratégia de decodificação. Modelos menores podem ter throughput alto em múltiplos pedidos, útil para servidores, mas não é a mesma coisa que velocidade individual.
O jeito de rodar importa mais que o nome do modelo
A diferença entre 23 tok/s e ~90 tok/s não é “a placa ficou mais rápida”. É o stack. O Qwen 27B em GGUF Q5 no llama.cpp mediu 23 tok/s na 3090 (bestmodel.run, medição do dono 28/09/2026). O Qwen 3.8 27B em EXL3 com decodificação especulativa DFlash2 no exllamav3 chegou a ~90 tok/s com especulação e primeiro byte < 1 s (docs/7-clientes.md). Nos logs do gateway, a média foi 70,9 tok/s e o máximo 101,8 tok/s em 14 respostas longas (LiteLLM SpendLogs, 28–29/09/2026).
Isso muda de 23 para ~90 tok/s, ou seja, 3–4x de velocidade (bestmodel.run, medição do dono 28/09/2026). Para uso interativo, essa diferença é enorme. Para geração longa, também.
Outro detalhe técnico: FP8 não roda em Ampere, e a RTX 3090 é Ampere (bestmodel measurements). Por isso, as configurações que funcionam bem aqui usam W4A16 ou EXL3, não FP8. Se você está comparando placas ou engines, não copie benchmark de FP8 para a 3090 e espere o mesmo resultado.
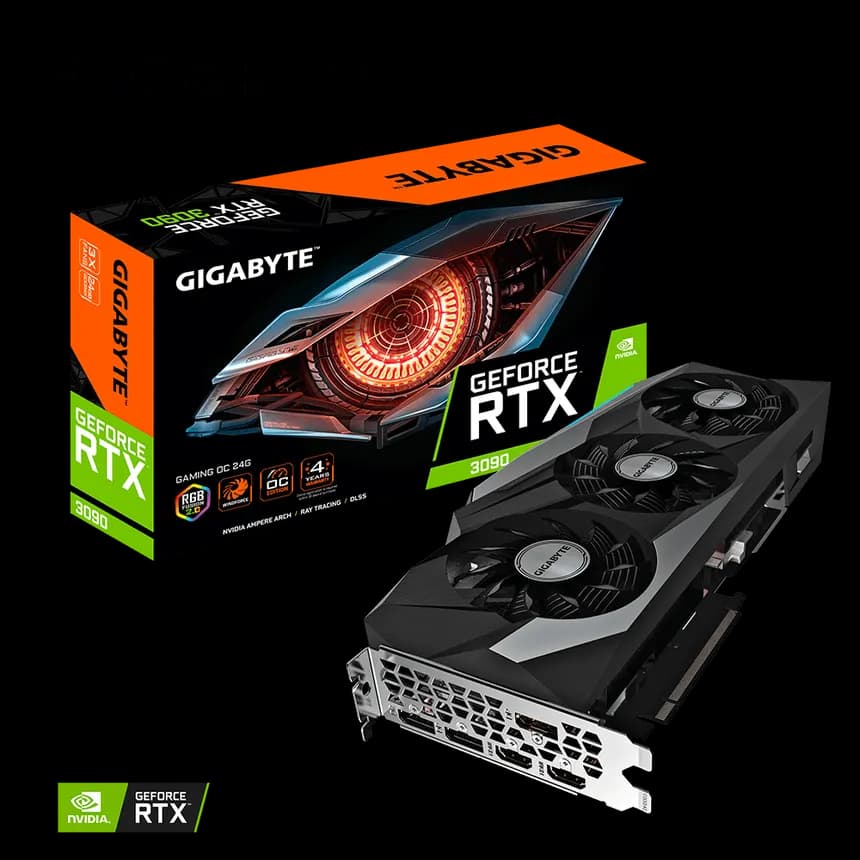
Gigabyte GeForce RTX 3090 24GB GDDR6X — Usada, Testada Antes do Envio
Modelo: Gigabyte GeForce RTX 3090 24GBO que ela já fez de trabalho real
Benchmark é bom, mas trabalho real é melhor. A placa escreveu código de produção que passou nos testes na 1ª tentativa nas stories DEV-1, DEV-2, DEV-3 e AG-3 do repositório inference-paraguai, com 1,8k, 14,4k e 6,3k tokens de saída (repositório inference-paraguai).
Isso não significa que ela resolve todo problema de software. Significa que, para tarefas mecânicas de desenvolvimento, ela produziu saída útil e verificável: cada story só foi aceita quando os testes dela passaram. Não foi “o modelo disse que estava pronto”. Foi o teste que aceitou.
A mesma regra vale no llms.surf (https://llms.surf), o despachante de tarefas que usamos: ele só aceita uma tarefa quando um comando real passa no disco — e a placa já está registrada lá como modelo local para tarefas mecânicas.
A escolha de usar Qwen 27B EXL3+DFlash2 como melhor modelo de código na 3090 saiu das medições publicadas no bestmodel.run (https://bestmodel.run). Isso é importante porque evita a armadilha de escolher modelo pelo nome, sem medir.
Estabilidade, temperatura e VRAM
Para vender uma placa como “como nova”, não basta ligar. É preciso mostrar que ela aguenta uso contínuo. A placa específica roda 24/7 como servidor de IA local numa máquina Xeon E5-2680 v4 (inference-paraguai/docs/status.md). Em 28/09, 121 de 121 healthchecks públicos retornaram HTTP 200 (report/health.csv). Após um kill -9, o servidor do Qwen voltou sozinho em ~58 s (docs/status.md).
Temperatura e consumo também foram medidos. Em ociosidade, a placa ficou entre 36–39 °C, com ~40–42 W (report/gpu.csv). Sob carga no Gemma, chegou a 45 °C e 100% de uso (report/gpu.csv, report/FINAL.md). Com Qwen 27B + draft, a VRAM ocupada foi de 22,1–22,9 GB de 24 GB (report/gpu.csv).
Isso mostra que o sistema não estava no limite térmico nem com VRAM estourando.
Para quem vale R$ 10 mil e para quem NÃO vale
Vale R$ 10.000,00 (produto /3090) se você quer rodar LLM local com 24 GB de VRAM, precisa de latência medida, quer manter dados locais, e está disposto a configurar o stack certo. Para quem usa IA para código, automações, servidores internos, ou tarefas repetitivas com testes, a 3090 ainda entrega resultado medido: ~90 tok/s com Qwen 27B em configuração otimizada, 66,5 tok/s com Gemma 4 12B em 1 pedido, e 485,7 tok/s somados em 8 pedidos simultâneos (docs/7-clientes.md, report/FINAL.md).
Não vale se você só joga. Este post não mede jogos, não compara FPS e não afirma performance em games. Se a sua prioridade é jogar, não use estas medições de LLM como argumento de compra.
Não vale também se você não quer mexer em Linux. Rodar LLM local com engines como exllamav3, vLLM e llama.cpp exige configuração, monitoramento e manutenção. Se você quer “instalar e esquecer” sem tocar em terminal, logs ou healthchecks, essa placa não é a escolha certa.
Não vale se você espera FP8 nativo. A 3090 é Ampere e FP8 não roda em Ampere (bestmodel measurements). Se o seu fluxo depende de FP8, procure outra arquitetura.
Placa de Vídeo NVIDIA GeForce RTX 5050 — Seminova, Garantia Estendida
Modelo: NVIDIA GeForce RTX 5050Como testamos antes de vender
O processo foi simples e documentado:
- Rodamos a placa 24/7 como servidor de IA local numa máquina Xeon E5-2680 v4 (inference-paraguai/docs/status.md).
- Medimos velocidade por modelo e engine, incluindo Qwen 3.8 27B em EXL3+DFlash2 e Gemma 4 12B em W4A16 (SPEC.md, docs/7-clientes.md, report/FINAL.md).
- Checamos disponibilidade com 121 de 121 healthchecks públicos em HTTP 200 em 28/09 (report/health.csv).
- Testamos resiliência com kill -9 e observamos retorno em ~58 s (docs/status.md).
- Monitoramos temperatura, consumo e VRAM: 36–39 °C e ~40–42 W em ociosidade; 45 °C e 100% de uso sob carga no Gemma; 22,1–22,9 GB de VRAM com Qwen 27B + draft (report/gpu.csv, report/FINAL.md).
- Validamos trabalho real com código de produção que passou nos testes na 1ª tentativa, com 1,8k, 14,4k e 6,3k tokens de saída (repositório inference-paraguai).
Se algum dado não está aqui, ele não foi usado. Não inventamos benchmark, preço de concorrente, consumo ou comparação fora das fontes listadas. Não há dado de jogos, FPS ou consumo em jogos neste post.
CTA
Se você quer uma RTX 3090 24 GB com histórico de uso real em IA local, a placa está disponível na Orbe: Gigabyte RTX 3090 24GB GDDR6X, condição como nova, R$ 10.000,00 (produto /3090). O atalho é /3090.
De onde vêm os números
- Hardware, 24/7 e Xeon E5-2680 v4: inference-paraguai/docs/status.md.
- Preço R$ 10.000,00 e condição como nova: produto /3090.
- Qwen 3.8 27B EXL3+DFlash2/exllamav3: SPEC.md (~34,5 tok/s sem especulação), docs/7-clientes.md (~90 tok/s, primeiro byte < 1 s), LiteLLM SpendLogs 28–29/09/2026 (média 70,9; máximo 101,8; 14 respostas longas).
- Qwen 27B GGUF Q5/llama.cpp: bestmodel.run, medição do dono 28/09/2026 (23 tok/s).
- Gemma 4 12B W4A16/vLLM: report/FINAL.md (66,5 tok/s, TTFT 253 ms; 485,7 tok/s somados em 8 pedidos).
- FP8/Ampere/W4A16/EXL3: bestmodel measurements.
- Healthchecks e kill -9: report/health.csv (121/121 HTTP 200 em 28/09), docs/status.md (~58 s).
- Trabalho real: repositório inference-paraguai (DEV-1, DEV-2, DEV-3, AG-3; 1,8k, 14,4k, 6,3k tokens).
- Temperatura, consumo e VRAM: report/gpu.csv, report/FINAL.md (36–39 °C, ~40–42 W; 45 °C, 100%; 22,1–22,9 GB).
- Escolha do modelo de código: bestmodel.run (https://bestmodel.run).
- Despachante de tarefas: llms.surf (https://llms.surf), registro do modelo local em model-registry.json.